这里是板块简介显示的地方

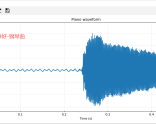
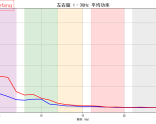
验证方法是: 读取 piano_binaural_10hz.wav 截取中间一段,例如 10 秒附近的 2 秒

使用 FFmpeg 1. 安装 Python 库 pip install numpy soundfile matplotlib 同时电脑需

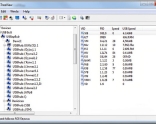
Windows的设备管理器中可以查看USB设备的信息: 驱动程序供应商:FTDI, 数字签名者:

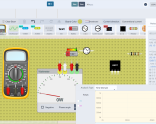
https://velxio.dev/ Arduino、ESP32 和 Raspberry Pi。 直接在您的浏览器中即可使

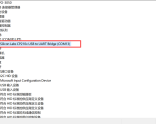
你的ESP32开发板被电脑识别为“CP2102”,这并不是一个错误,而是完全正常的现象。这

做固件加密,本质上是防止别人读取或复制你的程序。常见做法分为“芯片级保护 + 软件

高端神经反馈脑波检测系统分为脑波检测、脑波分析、脑波解码三个部分。 前端主程序

好的,我们来详细了解一下国内主流的第三方量化平台。这些平台极大地降低了个人投资者

1. 伪迹不是大脑信号 EEG设备记录的是头皮上非常微弱的电位变化(微伏级别,μV)。

项目起源: 初先生的聊天记录: 你那边掌握的技术,有办法做一个有摄像头的,墨者机
只需15分钟,就能训练高质量,个性化数字人大模型。由浙江大学与字节跳动联合推出MimicTalk算法,目前已 ...
一站式整合包如何制作 参考1: 半自动,用脚本来更新代码和组件 参考2: 解压即用的整合包制作方法: ...
SyncTalk是一种基于NeRF的高同步性说话人合成方法,专门针对提升说话人视频真实感和同步性而设计,克服了 ...
Wav2Lip是一种基于深度学习的人物口型生成技术,它可以将音频信号转化为对应的人物口型动画。 简单来说, ...
帧处理选择: face_enhancer 面部增强模型:选择512的模型,gpen_bfr_512,下载地址:https://huggingfac ...
每个人都能用的数字人 一、项目地址:https://github.com/kleinlee/DH_live 目前我们做数字人的通常做法 ...
虚拟人表情包自由livePortrait,真正实现表情自由 未完。。
metahumen数字人有着强大的生成工具,能在UE5中使用,同时支持out2face驱动,非常强大,但是,UE5+out2fac ...
有时候我们需要去掉视频中的字幕,可以使用牛片网的字幕抹除功能 项目地址:https://www.6pian.cn/User/Wa ...
ComfyUI 是一个强大且模块化的 Stable Diffusion 操作界面,与我们熟知的 WebUI 在底层上是一样的,只是它 ...
软件地址:https://www.vtubesound.com/ 主要功能: 软件目前支持Windows所有版本,暂无MAC版本。不支 ...
你想男声变女声吗?你想女声变男声吗?实现声音自由可以使用大饼AI变声。 官网地址:https://dubbing.tech ...
通过图像和动画的形式,解释深度学习是如何一步步简化复杂的事物的。 能够设置数据分布类型和测试集比例 ...
高性能低功耗的神经网络微模型开发迫在眉睫,一些前沿的大模型训练,每一年对算力需求的增长大概有 4-5 倍 ...
更早的时候市面上出现过一些3D数字人产品,但由于算力和成本等问题,它们不太适合直播带货使用,所以逐渐 ...
我们的真的实现了穿衣自由了吗?上传一张人物图片和衣服的图片,就能实现一键换衣。 这就是可图AI试衣项 ...
只需上传一段音频,就能快速克隆声音,输入文本就能快速生成口播语音。 项目地址:魔塔空间 https://www ...
数字人已经可以雇佣了吗?对,我就是一个被金双石科技雇佣的数字人,现在大家都可以去数字人雇佣市场雇佣 ...
1.语气的死板,数字人很难生成那种热情、欢快、俏皮、激烈、悲伤、撒娇的声音,都是中规中矩,像新闻播音 ...